Sự dao động 40% về độ chính xác và cái giá của thuật toán nén bộ nhớ
Báo cáo nghiên cứu khoa học được công bố cuối tháng trước bởi nhóm tác giả từ ByteDance kết hợp cùng các học giả thuộc Đại học Princeton, Đại học Stanford và Đại học California tại Berkeley đã đem lại một góc nhìn phản biện hiếm hoi đối với thành tựu của DeepSeek. Nghiên cứu chỉ ra rằng nỗ lực giảm tải dung lượng bộ nhớ cần thiết để xử lý các đoạn văn bản dài có thể làm tổn hại trực tiếp đến độ tin cậy của thuật toán, khiến mô hình dễ dàng bỏ sót thông tin quan trọng.
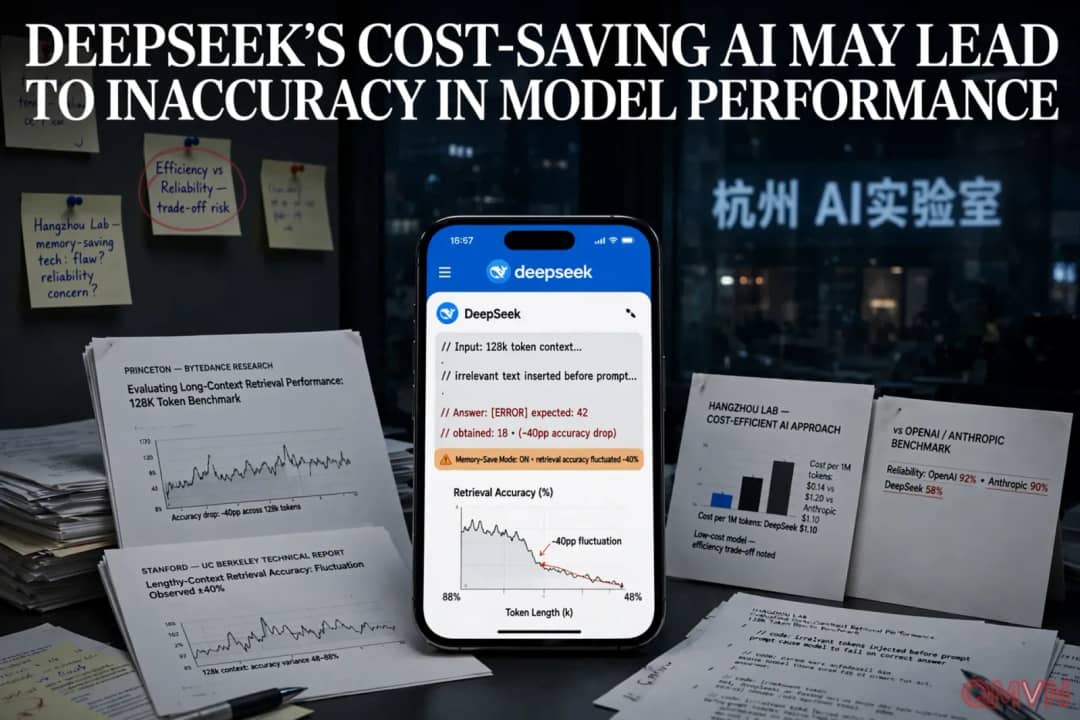
Các nhà nghiên cứu đã tiến hành thử nghiệm nhiều phiên bản mô hình DeepSeek về khả năng truy xuất thông tin từ ngữ cảnh dài lên tới 128.000 token – tương đương hàng vạn từ ngữ. Kết quả cho thấy độ chính xác truy xuất của dòng mô hình chủ lực DeepSeek-V4 và V4.1 có thể dao động và chênh lệch tới 40 điểm phần trăm.
Nguyên nhân xuất phát từ cách thức DeepSeek phân nhóm và nén thông tin trước khi lưu trữ, khiến một số chi tiết kỹ thuật trở nên khó phục hồi tùy thuộc vào vị trí của chúng trong các phân đoạn nén.
"Hiện tượng sụt giảm độ tin cậy này xuất hiện rõ nét ở DeepSeek-V4, V4.1 và trên toàn bộ các mô hình nén dữ liệu mà chúng tôi đã tiến hành tiền huấn luyện." - Trích báo cáo nghiên cứu của ByteDance, Đại học Princeton và Stanford
Nghiên cứu do ByteDance và các trường đại học hàng đầu của Mỹ (Princeton, Stanford, Berkeley) đồng thực hiện.
Độ chính xác truy xuất dữ liệu của dòng mô hình DeepSeek-V4 có thể sụt giảm tới 40 điểm phần trăm trong ngữ cảnh 128.000 token.
Việc bổ sung văn bản không liên quan vào trước đoạn mã lệnh có thể làm suy giảm nghiêm trọng khả năng đưa ra câu trả lời đúng của mô hình.
Rào cản vi mạch và thế lưỡng nan giữa chi phí vận hành và tính ổn định
Trong suốt thời gian qua, hiệu quả chi phí vượt trội luôn là điểm tựa tiếp thị cốt lõi giúp phòng thí nghiệm DeepSeek có trụ sở tại Hàng Châu vươn lên thành tâm điểm chú ý toàn cầu, thu hẹp khoảng cách công nghệ với các đối thủ hàng đầu nước Mỹ như OpenAI hay Anthropic. Chiến lược tối ưu hóa tài nguyên phần cứng mang ý nghĩa sống còn đối với các nhà phát triển AI Trung Quốc trong bối cảnh chịu các lệnh kiểm soát xuất khẩu vi mạch bán dẫn tiên tiến từ phương Tây.
Tuy nhiên, những phát hiện từ cuộc thử nghiệm thực nghiệm đã làm sáng tỏ một thách thức mang tính cấu trúc: sự đánh đổi giữa hiệu quả kinh tế và độ chuẩn xác tuyệt đối. Trong các ứng dụng thực tế đòi hỏi độ chính xác tuyệt đối như rà soát cơ sở dữ liệu pháp lý, phân tích tài liệu y khoa phức tạp hay lập trình phần mềm quy mô lớn, nguy cơ bỏ sót dữ liệu do thuật toán nén có thể dẫn tới những sai sót dây chuyền khó lường.
Khi các nhà phát triển cạnh tranh để làm cho các mô hình vừa mạnh mẽ hơn vừa có chi phí vận hành rẻ hơn, phát hiện này nhấn mạnh thách thức sống còn trong việc cân bằng giữa hiệu quả tài nguyên và độ tin cậy thực tế.
Ưu thế chi phí thấp từng giúp DeepSeek trở thành biểu tượng thu hẹp khoảng cách công nghệ AI với các gã khổng lồ Mỹ.
Các hạn chế tiếp cận chip bán dẫn tiên tiến buộc các hãng AI Trung Quốc phải tìm mọi cách tối ưu hóa thuật toán nén.
Giới nghiên cứu lưu ý thử nghiệm mới dừng lại ở quy mô phòng lab và chưa phản ánh toàn diện tần suất rủi ro trong ứng dụng thực tế.